pwinner
V2EX  ›  OpenAI

一些关于 openai 订阅降智,账号风控的独立测试

  •  
  •   pwinner · 1 day ago · 4521 views
    00.Background
    pro20x 日区账号,日本银行信用卡支付,日本手机号,ip 和账单地址对应,另有一台机器在东京另一处地区通过远程操作,两边都是 kddi 家宽,ip 对应地区一个在 23 区一个在横滨.
    开了高级安全认证,4 个 session,1 台有 codex 和网页(在横滨),1 台仅网页(在 23 区),1 台日本手机号物理在日本的手机

    01.发现降智与开始时间
    因为最近在做一些算法论文的复现和实验,加 highway+avx2/3 优化,涉及的东西相较于 crud 来说极端需要高质量的智能,上周五 tibo 宣布重置后使用时,对话 3 轮感觉 astra 速度变快,拒绝思考,给出的计算优化方向泛泛而谈之后立刻停手

    02.确诊
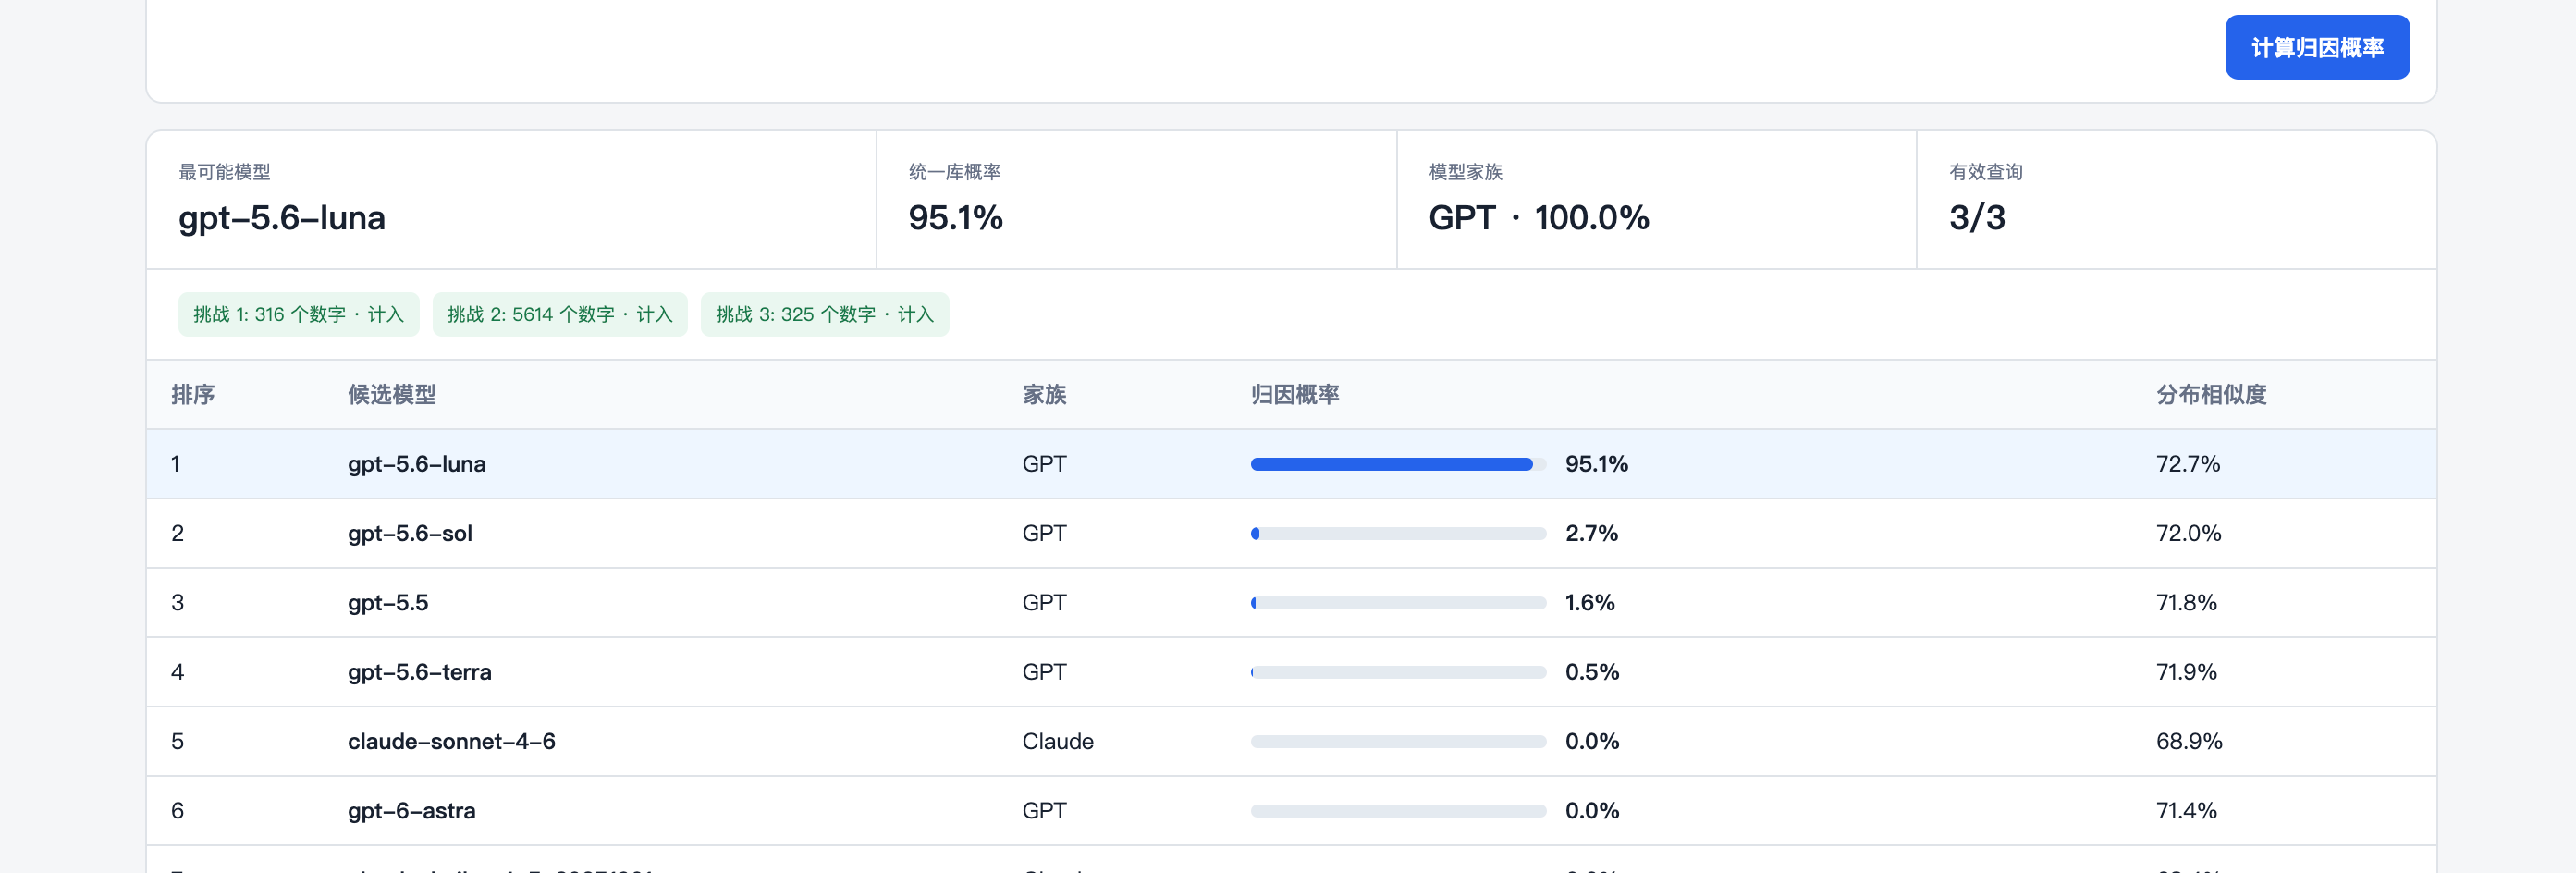
    通过模型指纹识别:https://xqy2006.github.io/ModelTrace/
    在进行所有测试后,确认 astra sol terra 和 5.5 均路由 luna,effort 不明,5.3-spark 这个工具没指纹,但是可以确认不是 luna:


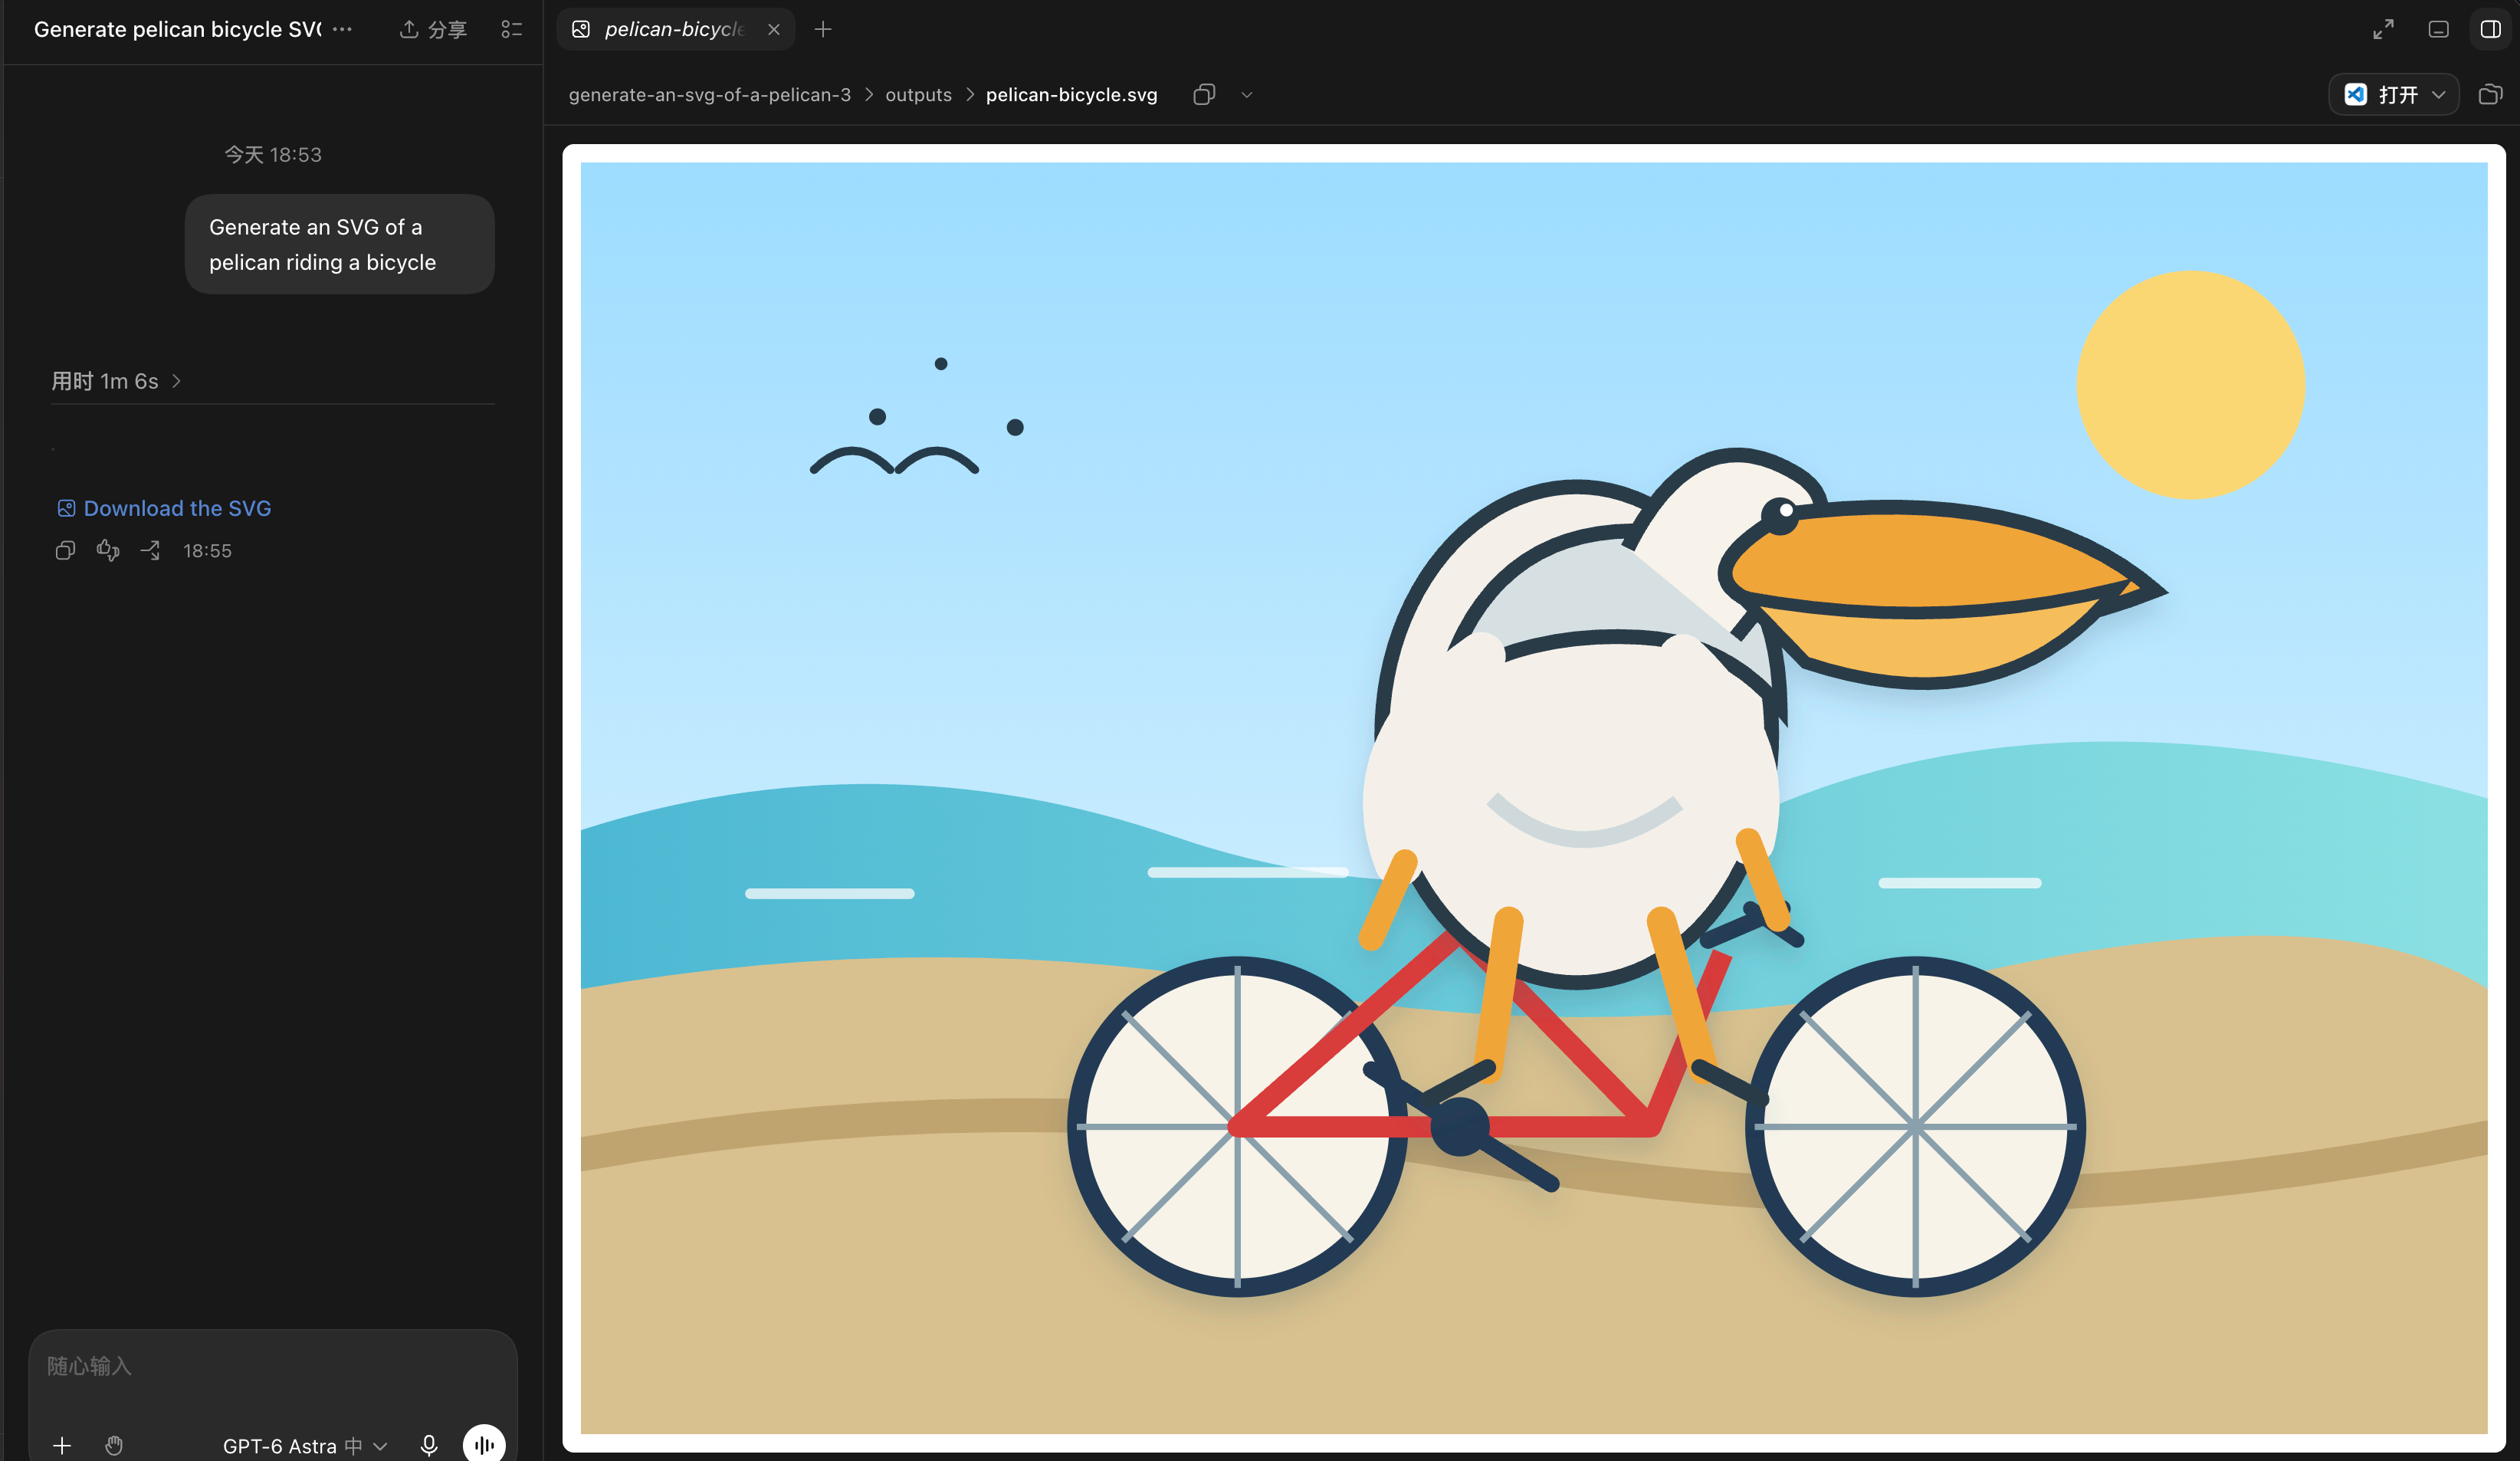
    鹈鹕测试则发现了显著的质量下降


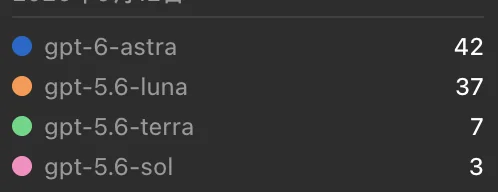
    同时可以从用量分析发现,astra 和 luna 的调用次数非常接近,这是以前从未有过的,之前仅用 astra 时他会自己调用 terra luna 偶尔 sol,分布是比较可预期的,但现在所有测试体感都按照 astra 计费,提供 luna 模型


    03.缓解与测试
    显著出现问题的,是访问网页端带来的风控:
    openai 内部有类似 10min/30min/1h/4h 的惩罚性风控,当发现问题后关闭所有客户端和网页端静置,最开始 10min 就能恢复,模型指纹能确认回到 astra,但是一旦访问了网页版 chatgpt,立刻变回 luna,同时,网页端的 6pro 目前也变得完全不可用,问什么问题都是被谨慎审视并且永远不返回任何结果,以“出错”结束.Work 调用的 astra 同样和 codex 一样是 luna

    第二天,再次尝试不访问网页的前提下使用 chatgpt desktop 进行尝试,第一个鹈鹕请求被“谨慎审视”,但是结果是正确的,后续所有请求被 route 到 luna,这种情况持续了一天,并且每次正常的 astra 请求都一定会被“谨慎审视”,然后立刻被 route 到 luna

    目前我仍然在用一次 astra-立刻只能使用 luna 的循环中,我没有其他可供测试的账号,没有其他设备进行干净登录,除此之外我尝试过删除.codex 文件夹重新启动和登录,依然可以稳定复现这个问题,不使用 desktop client,使用 cli 也会有这个问题
    Supplement 1  ·  1 day ago
    似乎今天降智的 pattern 发生了一些变化,但是可以发现的是,如果遇到“正在进一步审慎考虑此请求”,则一定是 astra,如果直接回答,则大概率是 luna,同时发生了一些类似按提问难度路由的可能.

    今天的观察是:早上第一个鹈鹕“审慎考虑”,输出正常,第二个鹈鹕直接输出,是 luna 水平,然后用隔壁网站提供的 prompt,又提示“审慎考虑”,输出正常,似乎现在并非一直路由 luna 了,似乎是按复杂度分类?但是我无法放心把目前的研究工作交给一个你永远不知道是什么模型的模型

    测试 prompt: 做一张精细的 SVG 图片,内容是鹈鹕骑着自行车在孙悟空开的大型飞机机翼上骑行,\ 鹈鹕展开翅膀,上面托着秦始皇的北极熊,秦始皇骑在熊上打螺丝。鹈鹕喊出\ “在一个黑色的袋子里放有三种口味的糖果,每种糖果有两种不同的形状(圆形和五角星形,不同的形状靠手感可以分辨)。现已知不同口味的糖和不同形状的数量统计如下表。参赛者需要在活动前决定摸出的糖果数目,那么,最少取出多少个糖果才能保证手中同时拥有不同形状的苹果味和桃子味的糖?(同时手中有圆形苹果味匹配五角星桃子味糖果,或者有圆形桃子味匹配五角星苹果味糖果都满足要求)苹果味 桃子味 西瓜味 圆形 7 9 8 五角星形 7 6 4”的结果数值
    Supplement 2  ·  1 day ago
    我发毒誓,我 2026 年 9 月 13 日,仅使用过 astra,没有使用过另外其他模型,但是非常可惜,我的分析用量并不这么认为

    Supplement 3  ·  11h 2m ago
    今天遇到了一些更有意思的现象,可以称为智力部分恢复,分享一下:
    在 Chatgpt web 端,使用指纹浏览器,我进行的以下行为顺序:
    1.画鹈鹕,prompt:创建一个 HTML ,内容是 SVG 绘制一个鹈鹕骑自行车的 2D 动画, 使用的是 astra 中,结果正确,但是起手就是一个“正在谨慎调查你的请求”
    2.询问一个复杂的算法问题,使用 astra 中,30 秒就返回结果,回答很糟糕
    3.画鹈鹕,prompt 同上,结果很糟糕
    4.使用 chat 的 6pro 询问同样的复杂算法问题和论文搜索要求,网页陷入了长时间的“正在谨慎调查你的请求”
    5.过了大概 5-10 分钟,这个 6pro 突然动起来开始真的干活了,并且工作了 20 分钟返回了一个我比较满意的答案
    6.这时候再问 astra max 同样的算法问题,跑了快 20 分钟都没跑完,思考很多
    7.我这时候想,嘿,难道说真的恢复了,于是我又开了一个 thread 画鹈鹕,prompt 同上
    8.这时候立刻,注意是鹈鹕提交之后立刻,astra max 的那个跑了 20 多分钟的 session 变成 at capacity 被停掉,重试也是 at capacity,再次重试变成了很短时间立刻回答我的垃圾回复
    9.画鹈鹕的那个 thread,也在接近结束时 at capacity 被停掉
    10.此时,我尝试再次询问 6pro,关于他回答问题算法的进 2 年成果和算法结果,被“正在谨慎调查你的请求”,被大调查了也大概 10 分钟,大调查完后,我将 6pro 分析结果给 astra max 延伸分析,astra max 行为正常,但是会跑个十几分钟突然 at capacity,重试会继续但是降智
    11.我把同样的分析结果的延展问题给 6pro,进入大调查阶段,目前在这个地方开始循环了.问问题-正常-第二个问题-降智-问 6pro-超级大调查然后正常-问问题-正常-过一会再问-降智

    基于静态分析 codex 客户端,telemetry 里有 codex.guardian_v2.connection.duration_ms 、guardian_credits_requested, 存在一个叫 Guardian 的 v2 审查服务,网页端一定有类似的东西,且抓包看到了大量的 cloudflare 挑战,但是最终是给你服务的,说明是分数触阈后的临时降档,可恢复,但是跑久了触发了什么东西突然不高兴了又给你掐了

    正在做进一步分析...
    43 replies    2026-09-15 15:22:35 +08:00
    andie
        1
    andie  
       1 day ago via Android
    我静置账号一天后解决,暂时稳定
    413420
        2
    413420  
       1 day ago
    有价值
    413420
        3
    413420  
       1 day ago
    op 现在做研究,会用 fable5.1
    413420
        4
    413420  
       1 day ago
    layxy
        5
    layxy  
       1 day ago
    我昨天使用了一天,codex 后台统计我昨天使用了
    gpt-6-astra 154 次
    gpt-5.6-luna 151 次
    gpt=5.6-terra 8 次
    问题我 codex 中一直设置的 gpt-6-astra medium,这个路由掺杂着 luna 导致我现在已经不太相信产出质量了,目前暂不清楚用户端使用显示的是 gpt-6-astra ,如果路由到 gpt-5.6-luna ,是按 gpt-6-astra 计费还是 gpt-5.6-luna 计费,这有点坑
    abc0123xyz
        6
    abc0123xyz  
       1 day ago
    web 端会导致风控吗?
    johnbobby
        7
    johnbobby  
       1 day ago
    DeepSeek 输出测试的,证明 DeepSeek 蒸馏 GPT 5.6 实锤了
    layxy
        8
    layxy  
       1 day ago
    @johnbobby 这个测试只有 13 个模型的指纹,其他模型的测试不准确
    johnbobby
        9
    johnbobby  
       1 day ago
    @layxy #8 无论输入来自什么模型,它最终都会把 100% 概率分配给这 13 个候选。

    在“真实模型一定属于这 13 个候选”的前提下,分类器经过校准后给 GPT-5.6 Sol 分配了 93% 的相对概率。
    pwinner
        10
    pwinner  
    OP
       1 day ago
    @layxy 这基本就是路由 luna 了,还收你 astra 的钱
    joshryo
        11
    joshryo  
       1 day ago
    [img][/img]
    pwinner
        12
    pwinner  
    OP
       1 day ago
    @413420 被封过 20x,不敢继续用了,怕是已经被打上标记了
    ncik20
        13
    ncik20  
       1 day ago
    什么叫访问网页端带来的风控,是使用网页版 chatgpt 会使 cli 降智?
    plants
        14
    plants  
       1 day ago   ❤️ 1
    A\直接封号都好过这种暗地降智
    pwinner
        15
    pwinner  
    OP
       1 day ago
    @ncik20 我一打开网页版 chatgpt,codex 客户端立刻,下一个请求变成 luna,暂不清楚原因,使用的是 safari
    111111111111
        16
    111111111111  
       1 day ago
    @ncik20 我猜是想表达: 网页使用过程中提供了更多信息,账号的风控被加强。
    也可能每天第一次使用之后被风控,如果网页使用则提前消耗掉了这一次
    pwinner
        17
    pwinner  
    OP
       1 day ago
    @111111111111 不算准确,不是每天第一次,而是每 X 小时后的第一次是正常的
    layxy
        18
    layxy  
       1 day ago
    @pwinner 体感应该是即便路由到 luna 等低级模型,也是按 astra 计费的,如果按照实际路由到的 luna 模型计费,我不太可能一天使用 pro 20x 25%的周限
    413420
        19
    413420  
       1 day ago via iPhone
    @pwinner 架不住 fable5.1 好用啊,这你能忍住
    pwinner
        20
    pwinner  
    OP
       1 day ago
    @413420 实际上,在极端针对计算性能优化和算法的能力上,sol 比 fable5 要强上不少,可惜我用不到 fable5.1,没法对比,但是两家对数学能力的大幅加强我认为都是不错的信号
    MiracleKoi
        21
    MiracleKoi  
       1 day ago
    看了下我的更离谱,被路由到 gpt 5.5 了,全程用的 astra max 。
    178 轮对话
    2026 年 9 月 13 日
    gpt-5.5 79
    gpt-6-astra 46
    gpt-5.6-luna 48
    gpt-5.6-terra 3
    gpt-5.6-sol 2

    不过指纹识别显示的是 100% gpt-6-astra 。
    413420
        22
    413420  
       1 day ago via iPhone
    @pwinner 数学确实,我写文本还是会用 fable5.1 ,更有人味,不过一些短篇小说的分析,astra 竟然会更有人味,所以也不能说哪一边更适合文本分析,我现在也很糊涂
    pwinner
        23
    pwinner  
    OP
       1 day ago
    @MiracleKoi 刚起床吗?前几次可能是好的,后面就一定坏了
    sentinelK
        24
    sentinelK  
       1 day ago
    LLM 用 token 收费我一直认为是非常流氓的一种行为。相当于 LLM 厂商只外租算力,但又不对算力的产出负责。

    卖铲子可以卖,也可以租铲子。但是我没见过按照铲子铲土的次数收费的。目前的卖 token ,就是按照铲子的挖土次数收费。

    首先,LLM 的产出本身就是不稳定的。
    其次,无论是从用户视角,还是厂商视角,都很难自证产出的实际“工艺”。
    最后,铲子能不能挖出金子,除了使用者的挖土技巧以外,铲子好不好用也是关键。


    所以与其于互相猜忌,不如要么就拿成果论,要么就拿工时论。
    也就是走向包月或推理时长(类似员工工资),或者结果审计(类似工程外包)。
    enrolls
        25
    enrolls  
       1 day ago
    "02.确诊" 可以走 CHAT/WORK, 然后 step by step 地测试。确实在 gpt-5.6-luna/gpt-5.6-sol 之间出现了路由。

    排序 候选模型 家族 归因概率 分布相似度
    1 gpt-5.6-luna GPT
    90.9%
    77.2%
    2 gpt-5.5 GPT
    8.3%
    76.5%
    3 gpt-5.6-sol GPT
    0.6%
    75.9%
    4 gpt-5.6-terra GPT
    0.1%
    75.3%
    5 gpt-6-astra GPT
    0.0%
    74.9%

    排序 候选模型 家族 归因概率 分布相似度
    1 gpt-5.6-sol GPT
    82.0%
    88.8%
    2 gpt-5.5 GPT
    17.7%
    87.7%
    3 gpt-5.6-luna GPT
    0.2%
    85.6%
    4 gpt-6-astra GPT
    0.1%
    86.9%
    5 gpt-5.4 GPT
    0.0%
    87.2%
    sentinelK
        26
    sentinelK  
       1 day ago
    目前 token 的计费形式就像是程序员用敲击键盘次数计费,销售按照步数计费。

    相当于用户把主动权完全让渡给了厂商,厂商只有当圣人才能保住用户的体验。
    pwinner
        27
    pwinner  
    OP
       1 day ago
    @sentinelK 反过来说,开源模型就没法干这种事情不是么,我认可你提到的售卖的是 token 而不是解决方案,但我认为这也算是过时的想法,因为对于 ai 厂商来说,售卖解决方案并不是终极目标,因为 ai 可以生成任何解决方案“自举”

    LLM 的产出本身就是不稳定的,但是高智力 AI 的行为表现可预测性往往是极高的,按 token 卖本身我认为不算是个问题,因为售卖的产品是“智能”,目前只有这一个度量方式叫 token,对于敏感的人和场景来说,智能的差距是非常巨大的,可能有些人被路由了也是后知后觉,我只需要 3 轮对话就会发现问题巨大

    真正的恶是挂羊头卖狗肉,我可以理解 openai 为了解决算力问题做的努力,但是隐式的这么做终究会逼走真正的用户

    但是,真的有那么多人需要这么强的智能吗?
    sentinelK
        28
    sentinelK  
       1 day ago   ❤️ 1
    @pwinner "真的有那么多人需要这么强的智能吗?"

    这个也是问题之一,就是其实没人能预测他的提示词到底需要什么“智能”才能实现他需要的结果。
    在这种情况下,既然让用户选了,那就应该听用户的。

    类似的,去年 copilot 出的 auto 就更合理。由 copilot 来选择任务需要的推理的模型,然后给用户打 9 折。
    sentinelK
        29
    sentinelK  
       1 day ago   ❤️ 1
    就是说,我认为用户和厂商的权责应该对等。目前的 token 计费的形式,对于厂商而言完全权责不对等,所有权利几乎都归于厂商,所有责任都归于用户。
    lzylzylzy130
        30
    lzylzylzy130  
       1 day ago
    测试看到是 astra ,但是 dashboard 确实看到有相当高的 luna 调用

    排序 候选模型 家族 归因概率 分布相似度
    1 gpt-6-astra GPT
    100.0%
    79.2%
    2 gpt-5.4 GPT
    0.0%
    77.4%
    3 gpt-5.6-sol GPT
    0.0%
    76.9%
    4 gpt-5.6-terra GPT
    0.0%
    76.8%
    cheng6563
        31
    cheng6563  
       1 day ago
    路由到 luna 算好的了,路由到 4o 的你就爽吧
    Alexliu
        32
    Alexliu  
       1 day ago
    Codex 的统计里面出现大量的 Luna 调用是正常的,或者说 OpenAI 还没蠢到这么暴露出模型路由

    codex-auto-review 这个自动审批背后就是 gpt-5.6-luna ,如果开了<帮我批准>,会产生很大量的 gpt-5.6-luna 调用
    wwwwjack
        33
    wwwwjack  
       1 day ago
    Deepseek V4 Pro 输出 99.6% cloud-sonnet-4-6 什么鬼?
    senyuLight
        34
    senyuLight  
       1 day ago
    @wwwwjack 说明 deepseek 蒸馏了,别人家的模型
    shugen
        35
    shugen  
       1 day ago
    今天变得太蠢了
    yihy8023
        36
    yihy8023  
       1 day ago
    补充一点 帮我批准用的 AutoReview 模型是 5.6Luna
    sentinelK
        37
    sentinelK  
       1 day ago
    @wwwwjack
    @johnbobby

    这叫“逆概率谬误”,通缉犯脸上有道疤 ≠ 脸上有疤的都是杀人犯
    yarawen
        38
    yarawen  
       1 day ago
    排除掉子 agent 的可能了吗
    pwinner
        39
    pwinner  
    OP
       1 day ago
    @yarawen 这几天,我只做了一件事,画鹈鹕,没可能画鹈鹕用子 agent
    mathiashu4
        40
    mathiashu4  
    PRO
       16h 9m ago
    看来我这个没掺水?
    MarcusCliff
        41
    MarcusCliff  
       15h 40m ago
    mkroen
        42
    mkroen  
       11h 12m ago
    我的 astra 输出了 3000 多个数字还一直不停下来🤡🤡
    pwinner
        43
    pwinner  
    OP
       10h 11m ago
    @mkroen 这就是 luna 无 reasoning 的智力,比 5.3spark 还要糟糕,而 5.3spark 输出的数字数量甚至是准确的,无降智
    About   ·   Help   ·   Advertise   ·   Blog   ·   API   ·   FAQ   ·   Privacy   ·   Solana   ·   1200 Online   Highest 6679   ·     Select Language
    创意工作者们的社区
    World is powered by solitude
    VERSION: 3.9.8.5 · 66ms · UTC 17:34 · PVG 01:34 · LAX 10:34 · JFK 13:34
    ♥ Do have faith in what you're doing.